A un paio di settimane dall’annuncio dei modelli 3.8 Flash e 3.8 Cyber e a tre settimane dall’annuncio del modello 3.5 Transcribe, Google ha annunciato un importante passo in avanti nel segmento dell’intelligenza artificiale conversazionale presentando i nuovi modelli Gemini 3.8 Live e 3.8 Live Extended Thinking.
I due nuovi arrivati sono progettati per rendere le interazioni vocali estremamente fluide e naturali, e per alimentare agenti in grado di gestire compiti complessi in tempo reale senza interrompere il dialogo dell’utente. Assieme a 3.5 Transcribe e ad altri modelli annunciati in precedenza, i nuovi modelli compongono la suite definitiva per gli sviluppatori che potranno creare le loro applicazioni vocali in tempo reale più avanzate. Scopriamo tutti i dettagli.
Indice:
Segui TuttoAndroid su Google Discover
Google ha annunciato due nuovi modelli IA conversazionale
Come anticipato in apertura, tramite un post sul blog ufficiale, Google ha annunciato i nuovi modelli di IA conversazionale Gemini 3.8 Live e Gemini 3.8 Live Extended Thinking, definiti come “i modelli di dialogo live più avanzati di sempre”.
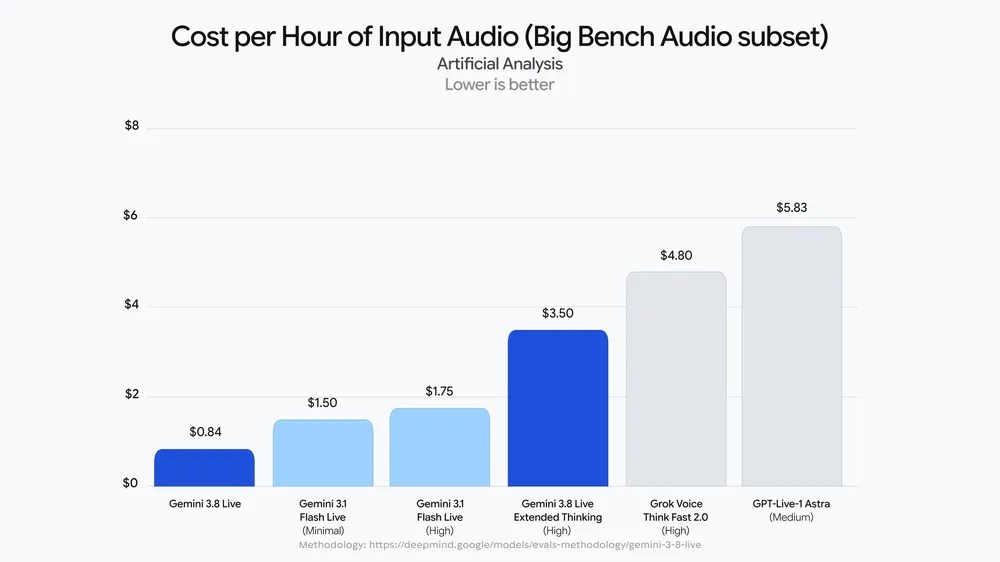
Questi nuovi modelli, al netto del solito rapporto costo/prestazioni tipico dei modelli della serie Flash, possono vantare importanti miglioramenti per quanto concerne intelligenza e ragionamento parallelo che li configurano come base ideale per agenti vocali affidabili.
Gemini 3.8 Live
Il nuovo Gemini 3.8 Live è stato sviluppato per offrire un’elevata efficienza operativa e un dialogo naturale. Esso combina intelligenza conversazionale e comprensione del contesto visivo con elaborazione degli input in tempo reale e riconoscimento automatico di 97 lingue e accenti diversi (e passaggio dinamico tra tutti).
Una delle peculiarità di questo modello è la sua capacità di eseguire strumenti in maniera asincrona e richiamare API in background. Grazie a ciò, esso può continuare a parlare e interagire con l’utente mentre completa operazioni esterne alla sessione.
Esempio 1
Gemini 3.8 Live guida l’inserimento dei nuovi dipendenti in tempo reale, utilizzando il contesto visivo per rispondere alle domande in tempo reale.
Esempio 2
Guarda Gemini 3.8 Live giocare a scacchi quasi in tempo reale, sfruttando il contesto visivo, il ragionamento e un flusso di conversazione naturale.
Gemini 3.8 Live Extended Thinking
Per i compiti ad alta complessità, invece, Google ha messo a punto Gemini 3.8 Live Extended Thinking, un modello concepito per eseguire ragionamenti multi-step avanzati mantenendo inalterata la fluidità del discorso.
La peculiarità di questo modello è la sua capacità di combinare elaborazione e sintesi vocale simultanee: anziché rimanere in silenzio durante il ragionamento e l’elaborazione in background, prende tempo come farebbe qualsiasi persona con frasi “spontanee” (ad esempio, “Fammi controllare”).
Questo approccio consente al modello di guidare l’utente attraverso flussi di lavoro complessi, dalla generazione di codice alla creazione di interfacce partendo da una bozza fino alla pianificazione aziendale.
Esempio 1
Guarda Gemini 3.8 Live Extended Thinking trasformare schizzi grezzi e feedback vocale quasi in tempo reale in componenti React funzionali.
Esempio 2
Guarda Gemini 3.8 Live creare piani aziendali completi e kit di strumenti di marketing personalizzati in tempo reale, utilizzando il linguaggio naturale.
Performance dei nuovi modelli
Sul piano delle prestazioni, il modello Gemini 3.8 Live ha conquistato il secondo posto nella Speech Agent Arena (piattaforma confronta modelli IA di tipo da voce a voce in conversazioni reali) e mostra un’elevata precisione nella gestione dei dati alfanumerici (come codici di verifica o numeri di pratica).
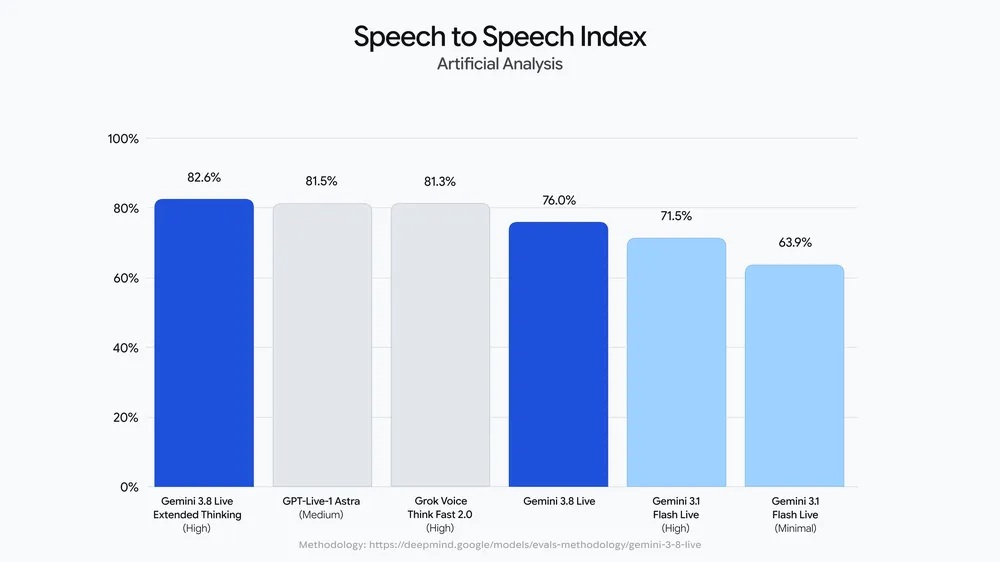
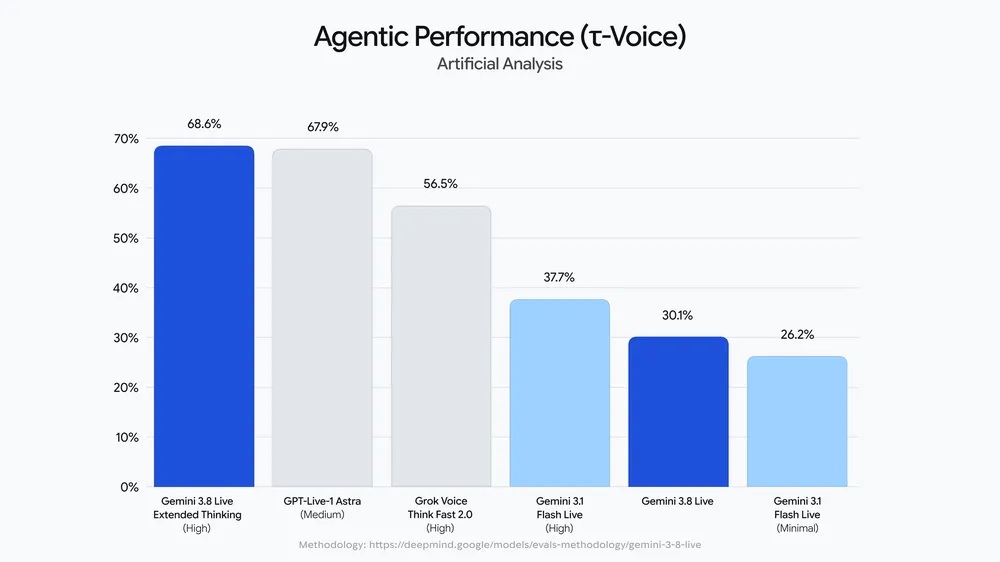
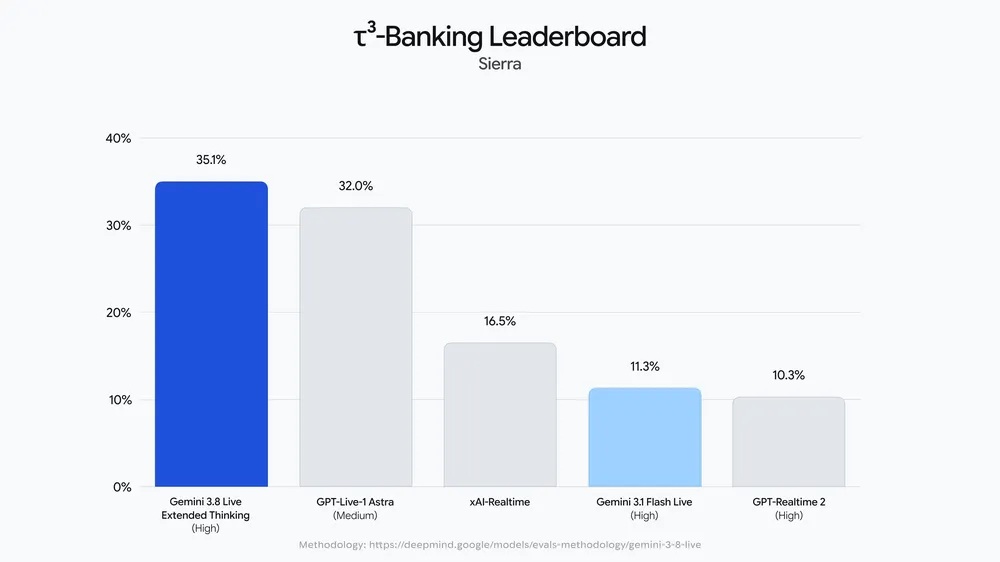
Per quanto concerne Gemini 3.8 Live Extended Thinking, i benchmark confermano la sua efficacia: il modello ha raggiunto il primo posto assoluto nell’indice di qualità Speech to Speech di Artificial Analysis e mostra risultati eccellenti nel completamento dei compiti agenziali.
Disponibilità dei nuovi modelli
I nuovi modelli di IA conversazionale appena presentati da Google sono già in fase di distribuzione a partire da oggi per sviluppatori, aziende e utenti consumer.
- Gemini 3.8 Live
- Sviluppatori – nell’API Gemini e in Google AI Studio
- Aziende – prossimamente su Gemini Enterprise (in anteprima privata)
- Utenti consumer – nella Ricerca Live della AI Mode
- Gemini 3.8 Live Extended Thinking
- Sviluppatori – nell’API Gemini e in Google AI Studio
- Aziende – prossimamente su Gemini Enterprise (in anteprima privata), su Gemini Enterprise for Customer Experience e per i clienti Google Workspace
- Utenti consumer – per tutti su Gemini Live, per gli abbonati a qualsiasi piano Google AI in Keep Live e Keep Live, per gli abbonati ai piani Google AI Pro e AI Ultra in Docs Live.

Segui Google su Telegram, ricevi news e offerte per primo
La suite “Gemini Audio” aggiornata è già disponibile per gli sviluppatori
Con i nuovi modelli Gemini 3.8 Live e 3.8 Live Extended Thinking, come raccontato tramite un altro post sul blog ufficiale, Google ha sostanzialmente messo a disposizione della community di sviluppatori una suite completa che può contare anche su:
- Gemini 3.5 Transcribe (un modello per il passaggio da voce a testo capace di operare su oltre 85 lingue)
- Gemini 3.5 Live Translate (annunciato a giugno, è un modello di traduzione vocale in oltre 70 lingue)
- Lyria 3.5 (annunciato a fine luglio, è il modello di generazione musicale più avanzato dell’azienda)
Tutti questi modelli sono disponibili da oggi nell’API di Gemini e in Google AI Studio per consentire agli sviluppatori di creare esperienze di prodotto basate sulla voce in tempo reale, ovvero tutta una serie di agenti che possono svolgere compiti di assistenza e affiancamento, anche interagendo con persone che parlano lingue diverse.